 Трендовые github проекты в нашем телеграм канале. Подпишись →
Когда пинг идёт, а сайт не открывается
Сервер в Москве, у российского хостера, отвечает на пинг без единой потери пакета. При этом сайт не открывается ни из дома, ни с мобильного, ни в браузере, ни через curl. Симптомы выглядят взаимоисключающими: сеть до хоста есть, а HTTP не проходит. Разбор ниже показывает, как дойти до причины методично, а не перебором гипотез — и что именно скрывалось за этим конкретным случаем.
Одиночная проверка ничего не доказывает при плавающем отказе
Первая ошибка на пути к диагнозу — попытка объяснить симптом одной правдоподобной версией. В этом случае внешний IP при подключении через VPN показывал Франкфурт, задержка до Москвы была 100 мс, и гипотеза «туннель теряет пакеты» звучала логично. Она не объясняла главного: без VPN сайт не открывался вообще, а туннель тут был ни при чём.
Правило простое: если у гипотезы остаётся симптом, который она не объясняет, гипотеза неверна целиком.
Вместо того чтобы гадать, отказ нужно мерить сериями запросов:
ok=0; fail=0
for i in $(seq 1 25); do
  c=$(curl -s -o /dev/null -m 10 -w "%{http_code}" https://example.ru/)
  [ "$c" = "200" ] && ok=$((ok+1)) || fail=$((fail+1))
done
echo "ok=$ok fail=$fail"
Серия из 25 запросов через VPN дала ok=18 fail=7 — 28% отказов. Само по себе число ничего не значит без контрольной группы: те же 25 запросов к google.com прошли 15 из 15, к сайту хостера — 12 из 12. Канал живой, чужие адреса открываются, не проходит конкретный хост.
Послойная проверка сужает круг втрое
Дальше отказ раскладывается по уровням стека — ICMP, чистый TCP-коннект, TLS-хэндшейк, HTTP-запрос:
ping (30 пакетов)            → 0% потерь
TCP-коннект :443             → 20 из 20
TCP-коннект :22              → 20 из 20
SSH-сессия                   → работает
curl HTTPS                   → 6 провалов из 20
curl HTTP :80                → 5 провалов из 15
Картина противоречивая: TCP-рукопожатие устанавливается всегда, SSH работает стабильно, а обычный HTTP-запрос падает в трети случаев с time_connect = 0.000000 — это значит, что соединение не установилось вообще, SYN ушёл и ответа не последовало для конкретного запроса, при том что рядом такой же TCP-коннект отработал успешно.
Логика такой раскладки: ping не идёт — лежит маршрут или хост; ping идёт, TCP нет — фильтрация; TCP идёт, TLS рвётся — фильтрация по SNI или DPI; всё идёт, падает только HTTP — проблема на самом сервере. В этом случае падали именно нижние уровни нестабильно, что сразу выводило из-под подозрения веб-сервер и приложение.
Шесть версий, которые проверяются и отбрасываются за минуты
Каждая гипотеза здесь проверяется одной командой и либо подтверждается фактом, либо снимается:
- Авария на ноде хостера — снимается через
load average 0.00, свободную память иnginxбез перезапусков: при аппаратном сбое страдал бы и SSH, а он работал стабильно. - Nginx или Docker не принимают соединения — снимается результатом «20 из 20» на чистом TCP-коннекте к 443: при переполнении accept-очереди падал бы и он.
- MTU и фрагментация — Path MTU до сервера оказался 1300 вместо 1500, характерная подпись туннеля, но у прежнего хостинга MTU был такой же, а проблем не было.
- Проблема с сертификатом — снимается тем же нулевым
time_connect: до TLS-хэндшейка дело просто не доходит, сертификат читается уже после установки соединения. - Отсутствие AAAA-записи — снимается принудительным
curl -4: те же потери идут и по чистому IPv4, IPv6 тут ни при чём. - IP в чёрных списках — проверка по шести DNSBL, включая Spamhaus и SpamCop, чистая.
Отрицательный результат по каждой версии — тоже результат: он методично сужает пространство причин, вместо того чтобы оставлять «наверное, дело в чём-то из этого».
tcpdump на сервере даёт однозначный факт вместо догадки
Решающий шаг — снять дамп трафика на сервере в момент отказа снаружи. Команда запускается через systemd-run, чтобы процесс пережил обрыв SSH-сессии:
systemd-run --unit=cap --collect \
  tcpdump -i any -nn -c 3000 -w /tmp/cap.pcap tcp port 443
Двадцать пять запросов снаружи, три из них с таймаутом. В дампе на сервере в момент этих трёх падений видно:
09:01:32.377365 In  IP клиент.443 > сервер.443: Flags [S]
09:01:32.377468 Out IP сервер.443 > клиент.443: Flags [S.]
09:01:32.476632 In  IP клиент.443 > сервер.443: Flags [.] ack
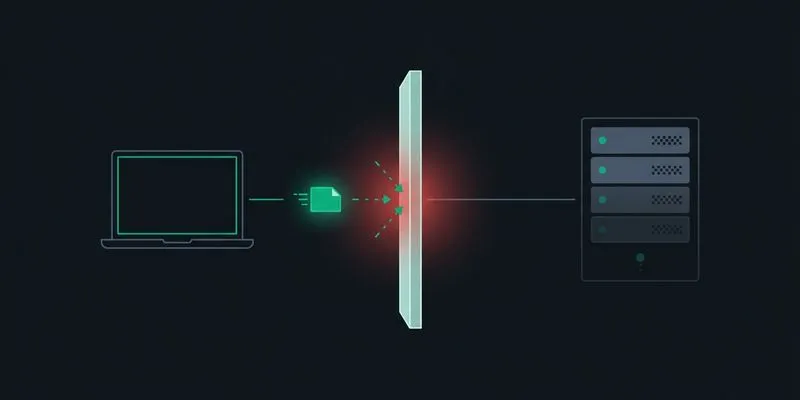
SYN дошёл, сервер ответил SYN-ACK за долю секунды, рукопожатие на его стороне завершилось — а curl на стороне клиента в этот момент показывал таймаут. Все 25 SYN дошли до сервера, ни один не потерялся по пути туда. Терялся ответный трафик на обратном пути, за пределами сервера.
Разница между VPN и реальным каналом снимает последнюю неопределённость
Проверка через реальный сетевой интерфейс, в обход VPN (в Windows — флагом --interface, адрес интерфейса смотрится через ipconfig):
curl --interface 192.168.1.50 https://example.ru/Результат по реальному каналу:
ping до сервера          → 6 из 6, 16 мс, 0% потерь
TCP на 443                → 0 из 10
TCP на 443 по IP          → 0 из 8
google.com                → 3 из 3
ICMP проходит идеально, TCP к 80/443 не проходит ни разу, другие сайты с того же интерфейса открываются без проблем. Это избирательная фильтрация конкретного TCP-направления при полностью живом ICMP, а не перегрузка канала или потери на маршруте.
Хостер подтвердил то же самое со своей стороны: порт открывается, nc -zv отвечает succeeded, но соединение рвётся на TLS-хэндшейке, curl виснет сразу после Client Hello, браузер выдаёт ERR_CONNECTION_RESET. Изнутри их сети тот же сайт отдаёт HTTP/2 200. Формулировка поддержки: изменения в фильтрации на стороне магистральных провайдеров, повлиять на них хостер не может.
Почему магистраль фильтрует конкретный адрес
Проверка принадлежности блока через RIPE Stat API:
curl -s "https://stat.ripe.net/data/prefix-overview/data.json?resource=ВАШ_IP" \
  | jq '.data.block, .data.asns'
Здесь важна методическая деталь: поле block в этом ответе отдаёт родительский диапазон по разметке IANA, а не фактического регистратора конкретной подсети. Ориентироваться на него как на «страну владельца адреса» — типовая ошибка, в которую легко попасть: адрес физически стоящего в Москве сервера может формально относиться к диапазону, выделенному под другой регион мира, при этом в самой базе RIPE у подсети стоит страна RU и российская организация-держатель.
Хостеры покупают такие блоки легально — свободных адресов в RIPE давно нет, а IPv4 нужны для новых серверов. Но магистральные провайдеры фильтруют по спискам диапазонов, и нетипичный для России блок целиком попадает под фильтр, если у соседей по подсети когда-то были основания для блокировки. Правильная проверка — не поле block в RIPE Stat, а фактическое присутствие своего блока в реестре российских диапазонов: конкретный проверенный диапазон в этом реестре отсутствовал, хотя физически и юридически был привязан к российскому хостеру.
Смена адреса у того же хостера на другой из освобождённого блока привела к тому же результату — новый диапазон снова оказался вне реестра российских адресов. Проблема снималась только переездом к хостеру, чьи диапазоны заранее проверены как зарегистрированные на Россию в RIPE, с предварительной проверкой доступности его сети с домашнего канала. После переезда серия из 12 запросов прошла 12 из 12 с задержкой 25 мс вместо 0 из 10 при 100 мс до этого.
Чек-лист для похожего случая
Первые три пункта занимают пять минут и отсекают половину ложных версий:
- Мерить сериями запросов, а не одним curl — плавающий отказ на единичной проверке выглядит как случайность.
- Держать контрольную группу — другие хосты через тот же канал, иначе замер ничего не доказывает.
- Раскладывать по уровням: ICMP → чистый TCP → TLS → HTTP. Место обрыва сразу указывает направление поиска.
- Сравнивать VPN и реальный интерфейс —
curl --interfaceна Linux/macOS, реальный адрес изipconfigна Windows. - Снимать tcpdump на сервере в момент внешнего отказа — это отвечает на вопрос, доходит ли SYN и отвечает ли сервер, без дальнейших догадок.
- Проверять IP-диапазон по факту присутствия в реестре, а не по полю
blockв RIPE Stat API — оно показывает родительский /8 по IANA и вводит в заблуждение. - Спрашивать у хостера происхождение IPv4-блока до оплаты — один вопрос в чат поддержки экономит день на последующий переезд.
Читайте также