 Трендовые github проекты в нашем телеграм канале. Подпишись →
Как ускорить сборку Python в 20 раз
Тестовый проект на Streamlit с набором сторонних зависимостей собирался в облаке 18 минут. После серии изменений сборка занимает 50 секунд, то есть примерно в 20 раз быстрее. Для лёгких Python-ботов выигрыш скромнее: они и раньше собирались за пару минут. Ниже разбор того, где именно уходило время и какие четыре изменения его вернули.
Задача возникла из практики: чем дольше сборка, тем меньше деплоев пользователь успевает сделать при отладке. В обычной разработке хватает одной-двух итераций, а при работе с ИИ-помощником, который пишет и правит код сам, итераций на порядок больше. Каждая лишняя минута ожидания умножается на десятки запусков.
Где теряется время при сборке
На удалённом сервере основное время съедают скачивание и установка зависимостей. Для Python это упирается в три фактора:
- PyPI режет скорость, когда загрузок слишком много;
- pip сам по себе работает не быстро;
- установка зависимостей занимает львиную долю всей сборки.
Помимо pip install в сборку входят архивирование, сохранение и скачивание архива с результатом, а также время, за которое Kubernetes планирует поды на нодах. Оптимизацию имеет смысл начинать с самого длинного этапа, где очевидно, что делать. Так и поступили.
Собственное зеркало PyPI
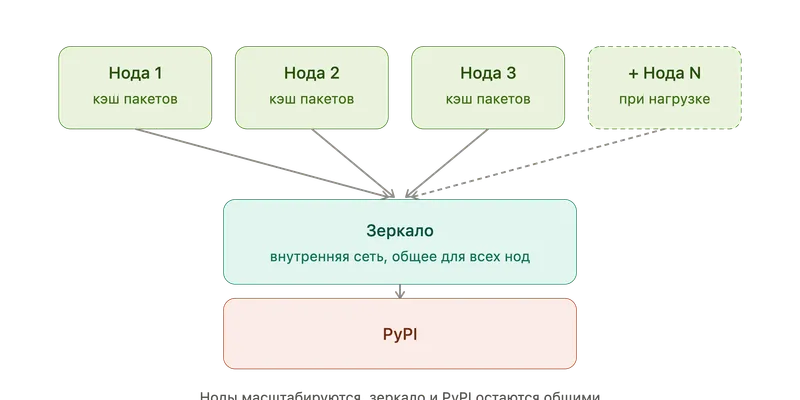
Первый шаг: локальное зеркало. Схема простая. Если пакета в зеркале нет, он скачивается из PyPI и остаётся в зеркале. Если есть, отдаётся оттуда. После наполнения к PyPI обращаются редко, а основной трафик идёт по внутренней сети.
Главный выигрыш здесь в стабильности скорости. В нормальном режиме PyPI отдаёт около 100 МБ/с. Когда превышается внутренний лимит по числу загрузок за единицу времени, скорость падает до 20–50 КБ/с, и зависимости качаются десятки минут. При большом числе сборок этот лимит срабатывал регулярно. Зеркало даёт стабильные 300–400 МБ/с.
Для проекта в домашней лаборатории или небольшой команде та же идея работает в меньшем масштабе: локальный прокси-кэш индекса пакетов (devpi, Nexus, Artifactory или любое другое зеркало) настраивается через index-url в pip.conf или переменную PIP_INDEX_URL, а в uv через UV_INDEX_URL. Сборочные агенты перестают зависеть от внешнего канала и от лимитов публичного индекса.
Переход с pip на uv
Второй шаг: замена pip на uv. Даже без «чистого» uv, только с pip-совместимым режимом uv pip, установка зависимостей на тестах ускорилась в 7 раз. Раньше платформа поддерживала только pip, теперь доступны и uv, и uv pip.
Причины скорости:
- uv написан на Rust;
- зависимости загружаются параллельно, тогда как pip ставит их последовательно;
- используется собственный кэш;
- разрешение конфликтов версий тоже отрабатывает лучше.
Минимальная миграция для существующего проекта с requirements.txt сводится к одной замене:
Вместо pip install -r requirements.txt запускается uv pip install -r requirements.txt.
Дальше можно переходить на нативный режим с pyproject.toml и uv sync, но первый прирост даёт уже замена одной команды.
Горячий кэш зависимостей на ноде
Зеркало убирает зависимость от внешней сети, но часть пакетов встречается в проектах постоянно. Гонять их по сети и ждать чтения с дисков или из S3 для них бессмысленно.
Для таких популярных зависимостей сделан горячий кэш прямо на ноде сборки. Эффект близок к локальной сборке на ноутбуке разработчика: пакеты уже лежат рядом с процессом установки. В итоговой схеме получается три уровня: кэш на ноде, затем зеркало во внутренней сети, затем PyPI как последний вариант.
Ноды с большим числом CPU
Сборка требует много вычислений. Системе нужно одновременно обрабатывать 10–15 сборок, в пиковые моменты до нескольких десятков (недавно зафиксировали 70 параллельных). Когда мощности нод не хватает, тормозит всё подряд.
В начале работ заметили, что существующие ноды не справляются в часы пик, и просто увеличили их количество и ресурсы CPU и ОЗУ.
Что стало сложнее
Каждый новый компонент даёт новые точки отказа. Из реальных инцидентов:
- на диске зеркала закончилось место, и часть зависимостей перестала устанавливаться;
- неверная настройка брокера сообщений привела к тому, что новые сборки не стартовали, и несколько часов не удавалось понять почему.
Оба случая разовые, их достаточно один раз отладить. Цена усложнения такая: зеркало, кэш на нодах, очередь сборок требуют мониторинга и администрирования. Практические выводы для любой похожей схемы: следить за свободным местом на хранилище зеркала, выводить в алерты состояние очереди сборок и отдельно проверять, что при недоступности зеркала сборка переключается на PyPI.
Что остаётся медленным
После оптимизации зависимостей узкие места сместились. Дольше установки пакетов теперь занимают:
- архивация и операции с архивом сборки;
- планирование подов оркестратором;
- запуск приложения после завершения сборки.
В среднем сам запуск кода в поде теперь занимает больше времени, чем сборка. Следующий этап оптимизации нацелен именно на эти шаги. Цель: чтобы проекты собирались и запускались в облаке так же быстро, как на локальной машине.
Что взять в свой CI и на домашний сервер
Порядок действий, который подтвердился цифрами:
- Замерить, сколько времени занимает установка зависимостей относительно всей сборки. Если она доминирует, начинать с неё.
- Заменить
pip installнаuv pip install. В тестах это дало 7-кратное ускорение установки при минимальных изменениях. - Поднять зеркало индекса пакетов во внутренней сети, если сборок много или внешний канал нестабилен.
- Держать горячий кэш популярных пакетов на самой сборочной ноде.
- Проверить загрузку CPU в часы пик и добавить ресурсов сборщикам, если параллельных сборок много.
- После этого заново замерить: узкое место почти наверняка сместится на архивацию, планирование подов или запуск.
Для тяжёлого проекта с 18 минутами сборки эффект получился максимальным. Для небольшого бота, который собирался пару минут, ожидание сократилось меньше, зато сложность инфраструктуры остаётся той же. Поэтому зеркало и кэш на нодах окупаются при большом потоке сборок, а замена pip на uv полезна в любом проекте.
Читайте также