 Трендовые github проекты в нашем телеграм канале. Подпишись →
Мастер или реплика: health-check’и HAProxy для кластера PostgreSQL
HAProxy сам по себе ничего не знает о ролях в кластере PostgreSQL. Ни Patroni, ни экземпляры не сообщают ему о switchover — балансировщик узнаёт о смене роли только из собственных проверок, которые повторяет через короткие интервалы. От того, как устроены эти проверки, зависит, куда попадёт запись после failover и сколько секунд клиенты будут получать ошибки.
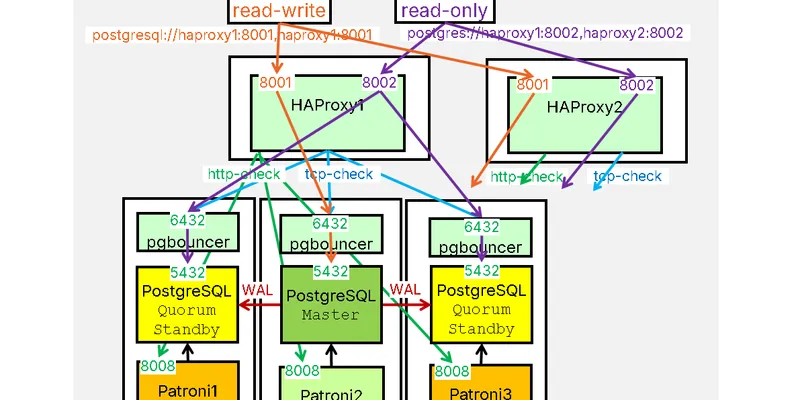
Типовая схема: два порта, один ведёт на мастер, второй — на реплики. Ниже три варианта проверки роли и одна дополнительная защита от split brain.
Вариант 1: Patroni REST API
Если кластером управляет Patroni, проще всего спрашивать его HTTP API на порту 8008: эндпоинт /primary отвечает 200 только на мастере, /replica — только на реплике.
listen primary
    bind *:8001
    option httpchk OPTIONS /primary
    http-check expect status 200
    default-server inter 2s fastinter 100ms downinter 2s fall 3 rise 2 observe layer4 error-limit 1 on-error fastinter init-state down on-marked-down shutdown-sessions
    server wtantor1 127.0.0.1:5432 maxconn 100 check addr 127.0.1.1 port 8008
    server wtantor2 127.0.0.1:5433 maxconn 100 check addr 127.0.1.2 port 8008
    server wtantor3 127.0.0.1:5434 maxconn 100 check addr 127.0.1.3 port 8008
Секция replica такая же, с /replica и портом 8002. Адрес Patroni API (check addr ... port 8008) может отличаться от адреса самого PostgreSQL.
Два параметра здесь обязательны:
init-state down— после старта или reload сервер считается недоступным, пока не пройдёт проверку. Без него HAProxy сразу пустит трафик на все три узла, включая реплики в пуле мастера.on-marked-down shutdown-sessions— при падении проверки HAProxy рвёт уже установленные сессии. Как минимум для реплик это нужно: иначе клиенты останутся подключены к бывшей реплике, ставшей мастером.
default-server удобно вынести в defaults. Такая конфигурация рекомендовалась ещё в 2020 году и до сих пор годится; с тех пор в HAProxy добавились observe, linger и балансировка leastconn.
Ограничение одно, но существенное: способ работает, только пока Patroni активен. Если кластер поставлен на паузу (maintenance mode — так делают при обновлениях и переконфигурировании), полагаться на REST API нельзя. Тогда HAProxy нужно перевести на проверки напрямую в PostgreSQL. Конфиг перечитывается бесшовно: старые сессии дорабатывают на старой конфигурации, новые идут по новой.
Вариант 2: in_hot_standby из ответа на подключение
Начиная с PostgreSQL 14 сервер сразу после аутентификации отправляет клиенту пакет ParameterStatus (S) с параметром in_hot_standby. На мастере там off, на реплике — on. Значит, роль можно определить, отправив один стартовый пакет и не выполняя ни одного запроса.
listen master1
    mode tcp
    bind *:8001
    option tcp-check
    tcp-check connect linger
    tcp-check send-binary 00000041000300007573657200706f7374677265730064617461626173650074656d706c61746531006c6f675f646973636f6e6e656374696f6e73006f66660000
    tcp-check expect binary 696e5f686f745f7374616e646279006f666600
    tcp-check send-binary 5800000004
    server r1 127.0.0.1:5432 check
    server r2 127.0.0.1:5433 check
    server r3 127.0.0.1:5434 check
Для пула реплик меняется только ожидаемая строка: ...006f6e00 (on) вместо ...006f666600 (off).
Что лежит в стартовом пакете
Hex-строку придётся править под своего пользователя и базу, поэтому её структуру полезно знать:
| Байты | Значение |
|---|---|
00000041 | длина пакета, 65 байт; у Startup нет байта типа |
00030000 | версия протокола 3.0 |
7573657200 + 706f73746772657300 | user\0postgres\0 — единственный обязательный параметр |
646174616261736500 + 74656d706c6174653100 | database\0template1\0 — опционально, по умолчанию база с именем пользователя |
6c6f675f646973636f6e6e656374696f6e73006f666600 | log_disconnections\0off\0 |
00 | завершающий нулевой байт |
template1 выбран потому, что эта база есть в любом кластере. Передача log_disconnections=off избавляет лог от записи об отключении на каждую проверку. С log_connections такой трюк не работает — сервер не даёт клиенту отключить логирование подключений.
Без user сервер ответит ошибкой 28000 no PostgreSQL user name specified in startup packet. Минимальный рабочий пакет:
tcp-check send-binary 00000017000300007573657200706f7374677265730000Весь пакет стоит отправлять одной директивой send-binary. В сети встречаются примеры, где его режут на несколько директив, — каждая порождает отдельный TCP-фрейм, и пакетов становится больше.
Что приходит в ответ
При trust-аутентификации сервер одним TCP-фреймом возвращает R с AuthenticationOk (520000000800000000), 15 пакетов S с параметрами статуса, K с PID и cancel-ключом и Z (ReadyForQuery). Проверять отдельно R не нужно: если в ответе есть in_hot_standby, аутентификация уже прошла. Полная форма с заголовком пакета — 5300000017 + строка для off и 5300000016 для on (длины 23 и 22 байта), но последовательность in_hot_standby\0off\0 в других пакетах не встречается, так что заголовок можно опустить.
Зачем linger и пакет X
tcp-check connect linger позволяет HAProxy корректно отправить Terminate (5800000004) перед закрытием сокета. Без него на каждую проверку в логе PostgreSQL появляется could not receive data from client: Connection reset by peer — при интервале в 2 секунды и трёх узлах это быстро засоряет лог.
Вариант 3: SELECT pg_is_in_recovery()
Третий способ — выполнить настоящий запрос. Это лишний сетевой roundtrip, зато проверка подтверждает, что экземпляр способен выполнить SQL-запрос.
tcp-check send-binary 0000004100030000...0000            # Startup
tcp-check expect binary 5a000000                          # Z: готов к командам
tcp-check send-binary 510000002073656c6563742070675f69735f696e5f7265636f7665727928293b00
tcp-check send-binary 5800000004                          # X: Terminate
tcp-check expect binary 66430000000d                      # 'f' + CommandComplete
51 — пакет Query (Q) длиной 32 байта с текстом select pg_is_in_recovery();. В ответе сервер присылает RowDescription (T), DataRow (D) со значением f или t, CommandComplete (C, тег SELECT 1) и Z. Проверка 66430000000d ловит стык: последний байт DataRow f (0x66) и начало CommandComplete. Для реплик ожидается 74430000000d (t).
Порядок важен: send-binary 5800000004 стоит до последнего expect. HAProxy прекращает выполнять директивы после первой неудачной проверки, и если поставить Terminate после expect, на неподходящем узле сессия будет обрываться без корректного закрытия.
На текущий момент pg_is_in_recovery() — самый надёжный из прямых способов. Патч, который позволил бы postmaster отдавать роль по GET без аутентификации и порождения backend-процесса, в апстрим, судя по реакции Tom Lane, не попадёт.
Защита от split brain через nbsrv
Patroni не допускает двух мастеров одновременно. Без Patroni или во время паузы эту гарантию теряют: если вручную сделать promote реплики, не остановив старый мастер, оба экземпляра пройдут проверку на off. HAProxy может отказывать в подключении, пока мастер не останется ровно один. Для этого listen разбивается на frontend и backend:
frontend masterf
    mode tcp
    bind *:8001
    acl single_master nbsrv(master1) eq 1
    tcp-request connection reject if !single_master
    default_backend master1

backend master1
    mode tcp
    option tcp-check
    # ... проверки на мастер ...
    server r1 127.0.0.1:5432 check
    server r2 127.0.0.1:5433 check
    server r3 127.0.0.1:5434 check
nbsrv(master1) считает живые серверы в бэкенде. Если их два, новые подключения на запись отклоняются: выбирается согласованность ценой доступности, как и в самом Patroni. С Patroni этот приём тоже полезен — как второй рубеж. Секцию реплик можно оставить в форме listen.
pgbouncer и устаревший in_hot_standby
Если pgbouncer стоит за HAProxy (между HAProxy и PostgreSQL) или клиенты ходят в pgbouncer, который подключается к экземплярам напрямую, есть проблема (issue #859). pgbouncer умеет кэшировать только параметры статуса, которые может менять клиент, — 10 из 15 через track_extra_parameters. in_hot_standby в этот список не входит. После promote реплики PostgreSQL присылает S с off, но pgbouncer продолжает отдавать своим клиентам on.
Клиент с target_session_attrs=primary или read-write после этого отказывается работать:
psql: error: connection to server at "127.0.0.1", port 5434 failed: server is in hot standby modeОбходных путей два: использовать target_session_attrs=any или рвать серверные сессии pgbouncer при смене роли. Второе делается callback’ом Patroni:
#!/usr/bin/bash
ACTION=$1; ROLE=$2; CLUSTER_NAME=$3
[ "$ACTION" = "on_role_change" ] && [ "$ROLE" = "primary" ] && \
psql -h localhost -p 6432 -d pgbouncer -c "RECONNECT"postgresql:
callbacks:
on_role_change: /opt/tantor/etc/patroni/callback.shЕсли pgbouncer стоит перед HAProxy, проблемы нет: HAProxy с shutdown-sessions сам разрывает соединения с узлом, сменившим роль, и pgbouncer переподключается. Такую схему выбирают, чтобы клиенты не замечали обрывов при switchover; перед плановым переключением pgbouncer можно поставить на паузу.
Какой вариант брать
- Patroni работает в штатном режиме — проверки через REST API с
init-state downиshutdown-sessions. - Patroni на паузе или его нет —
pg_is_in_recovery()через tcp-check;in_hot_standbyдешевле на один roundtrip, но не подтверждает, что узел выполняет запросы. - Возможны ручные promote — бэкенд мастера оборачивается в
frontendсnbsrv(...) eq 1. - pgbouncer между HAProxy и PostgreSQL — callback с
RECONNECTнаon_role_change.
В общих defaults полезно держать balance leastconn, retries 2, option redispatch, timeout connect 1s и timeout check 2s, а timeout client/timeout server выставлять не меньше net.ipv4.tcp_keepalive_time (7200 секунд по умолчанию), чтобы HAProxy не рвал долгие простаивающие сессии раньше keepalive.
Читайте также