 Трендовые github проекты в нашем телеграм канале. Подпишись →
API, PostgreSQL, Redis и воркеры: что команда обслуживает сама на VM, в Compose и на managed-платформе
Возьмём типовой небольшой сервис: HTTP API на Python, Go или Node.js, PostgreSQL для данных, Redis для кеша и очереди задач, один или несколько воркеров. Требования к нему тоже типовые:
- упавший процесс поднимается автоматически;
- релизы выходят без простоя или с перерывом, который допускает продукт;
- staging не зависит от production и не влияет на него;
- бэкапы PostgreSQL регулярно проверяются восстановлением;
- мониторинг показывает доступность API, время ответа и количество ошибок 5xx.
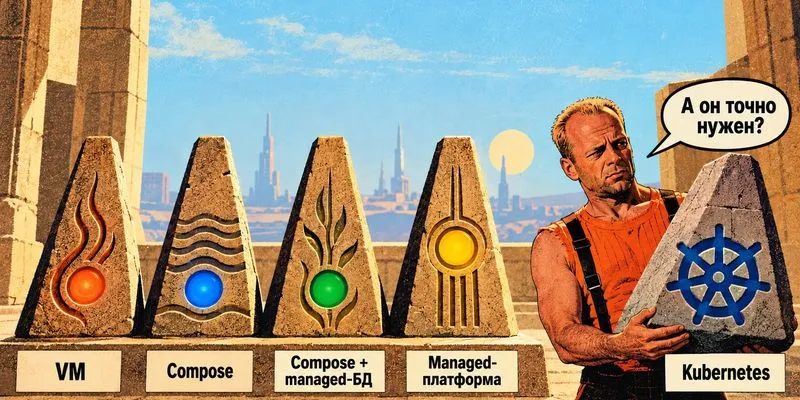
Ниже четыре способа закрыть этот список. Схемы независимы и не образуют лестницу роста: managed-базу можно подключить и к приложению на VM без контейнеров.
Схема А: одна VM, systemd и Nginx
API, воркеры, PostgreSQL и Redis работают на одной машине без контейнеров. Systemd запускает процессы, Nginx принимает запросы, настройки описаны в Ansible, сборку и деплой запускает CI/CD.
Рестарт. В unit-файле задаётся Restart=on-failure или Restart=always. Если API не может подключиться к PostgreSQL, повторный запуск проблему не решит: systemd отвечает только за процесс.
Релизы. Blue-green работает и на одной машине: новая версия стартует на другом порту, проходит проверку, Nginx переключается на неё, старая останавливается. Этот сценарий команда пишет и поддерживает сама, а миграции БД и совместимость двух версий продумывает отдельно.
Staging. Отдельная VM, настроенная теми же плейбуками, что и production.
Бэкапы. pg_dump даёт логический дамп. Чтобы вернуть базу к конкретному моменту, нужны физические копии и архив WAL. Копии хранятся вне production-машины: бэкап на том же диске пропадёт вместе с ним.
Отказ VM останавливает весь стек. Менять схему пора, когда сервер отнимает слишком много времени или одна машина не даёт нужной доступности.
Схема Б: всё в Docker Compose на одной VM
Те же компоненты переезжают в контейнеры, версии образов и параметры запуска описаны в compose.yaml. Граница отказа осталась прежней: Compose не перенесёт контейнеры на другую машину.
services:
  api:
    image: registry.example.com/api:1.4.2
    restart: unless-stopped
    healthcheck:
      test: ["CMD", "curl", "-f", "http://localhost:8000/health"]
      interval: 10s
      timeout: 3s
      retries: 3
Здесь легко ошибиться в ожиданиях. restart: unless-stopped срабатывает, когда завершается основной процесс контейнера. Healthcheck помечает контейнер как unhealthy, и в связке Docker Engine и Compose этот статус сам по себе рестарт не запускает. API может зависнуть, получить метку unhealthy и продолжить висеть.
Реакция зависит от типа сбоя:
| Что случилось | Что делать |
|---|---|
| Процесс упал | Перезапустить |
| Экземпляр временно не готов принимать запросы | Убрать из балансировки, если такой механизм настроен |
| Выросли задержки или доля ошибок | Отправить оповещение и разбираться |
docker compose up -d релиз без простоя не гарантирует. Рабочий вариант похож на схему А: поднять новую версию рядом со старой, проверить и переключить трафик через Nginx. Скрипты для этого снова пишет команда, и на ней же остаются VM, Docker Engine, сеть, откаты, бэкапы, логи и метрики. Для staging нужна отдельная VM с тем же Compose-файлом, своими переменными окружения и данными.
На Compose можно расти, пока хватает одной машины. Другие варианты нужны, когда контейнеры приходится размещать и обновлять на нескольких узлах.
Схема В: Compose для приложения, managed-сервисы для данных
API и воркеры остаются в Compose, PostgreSQL и Redis уходят к провайдеру. Часть работы с бэкапами, обновлениями СУБД, метриками и резервными узлами берёт на себя платформа. Какая именно часть, зависит от конфигурации: функция может быть доступна в сервисе и при этом выключена у вас, поэтому расписание копий, срок их хранения и параметры отказоустойчивости надо проверять для своего кластера.
Перед выбором базы ответьте на два вопроса:
- RPO (Recovery Point Objective): изменения за какой период допустимо потерять?
- RTO (Recovery Time Objective): сколько сервис может быть недоступен на время восстановления?
Единых значений для managed PostgreSQL нет: они зависят от конфигурации, репликации, бэкапов и самого сбоя.
VM с Compose остаётся единой точкой отказа для API и воркеров. На команде релизы, staging, сеть и доступы до managed-сервисов, секреты, обработка обрывов соединений.
Если приложение помещается на одной VM и её ограничения приемлемы, на Kubernetes можно не переходить.
Схема Г: managed-платформа и managed-данные
API и воркеры упакованы в контейнеры и работают на платформе провайдера, которая может управлять экземплярами, перезапускать их, менять число реплик, настраивать HTTPS и собирать метрики. Слово «managed» само по себе ни автоскейлинга, ни релизов без простоя не обещает, так что наличие этих функций проверяется по условиям конкретного сервиса.
Совместимого контейнера для переезда мало. Чтобы платформа могла заменять и масштабировать экземпляры, приложению часто приходится стать stateless. Долгую задачу из веб-процесса может понадобиться вынести в воркер, а загруженные пользователями файлы — с локального диска во внешнее хранилище.
До переезда выясните, какие runtime и форматы контейнеров поддерживаются, сколько живут локальные данные, как работают фоновые задачи и долгие соединения, какие лимиты действуют на ресурсы, время работы и сетевые подключения.
Стоимость считайте на своей нагрузке: при постоянной высокой загрузке VM может обойтись дешевле, но в расчёт надо включить и время команды на её обслуживание.
Бэкап и реплика закрывают разные сбои
Бэкап возвращает данные. Реплика и failover помогают пережить отдельные сбои с меньшим простоем. Резервный узел копии не заменяет: случайный DELETE может доехать и до реплик.
В любой из четырёх схем команда должна знать, где лежат копии, как поднять базу, проверить данные и подключить приложение. Регулярно восстанавливайте тестовую базу из бэкапа и замеряйте время. Так вы узнаете, укладываетесь ли в RPO и RTO.
Что есть между Compose и Kubernetes
Docker Swarm, Nomad, k3s, Kamal и Uncloud решают разные задачи: одни распределяют контейнеры по узлам, другие помогают выпускать релизы. k3s при этом сам является дистрибутивом Kubernetes.
Реплики на разных машинах с переживанием отказа узла и удобная доставка новой версии на один сервер — две разные задачи. Во втором случае полноценный оркестратор может добавить больше работы, чем сэкономит.
Четыре вопроса перед переходом на Kubernetes
Какие задачи должен решить оркестратор? Kubernetes размещает контейнеры на узлах, поддерживает число реплик, обновляет их и проверяет состояние. Это помогает, когда компоненты масштабируются независимо. Количество сервисов ни о чём не говорит: пять приложений могут обойтись без кластера, а одному он может понадобиться.
Есть ли польза от декларативного описания? Kubernetes описывает более широкий набор ресурсов, чем Compose: развертывания, сетевые сервисы, политики доступа. Это окупается, если конфигурация лежит в Git, используется GitOps и окружений несколько.
Кто будет эксплуатировать кластер? Managed Kubernetes снимает часть забот о компонентах управления. Рабочие узлы, лимиты контейнеров, сеть, обновления, мониторинг и поиск причин сбоев остаются на людях, которые должны в этом разбираться.
Оправдывают ли требования стоимость? У кластера есть собственные компоненты, которые надо оплачивать и обслуживать. Переход может окупиться, если нужны реплики на разных узлах, автоматическое размещение контейнеров, управляемые обновления и общий способ запускать приложения.
Что выбрать
- Внутренний сервис, прототип или невысокая нагрузка, команда знает Linux: VM без контейнеров.
- Нужно одинаково описать окружения в одном файле, а простой при отказе хоста допустим: Compose на одной VM.
- Compose устраивает, но бэкапы, обновления и резервные узлы съедают время: Compose плюс managed PostgreSQL и Redis.
- Приложение укладывается в правила платформы, и серверы хочется отдать провайдеру: managed-платформа.
- Задачи оркестрации названы, окупают кластер, и есть кому его эксплуатировать: Kubernetes.
Если главная боль — бэкапы PostgreSQL, ручной деплой или одна VM, начинайте с неё. Сохранность данных и отсутствие простоев Kubernetes сам по себе не обеспечит.
Читайте также