 Трендовые github проекты в нашем телеграм канале. Подпишись →
Кто оплачивает повторный запрос к модели
Пользователь закрыл вкладку с генерируемым ответом. Соединение с приложением оборвалось, но запрос к модели может продолжать работать и расходовать токены. В логах приложения — незавершённый HTTP-запрос, в статистике провайдера — платная генерация. Если между ними нет общего идентификатора и учёта потребителя, объяснять расходы придётся вручную.
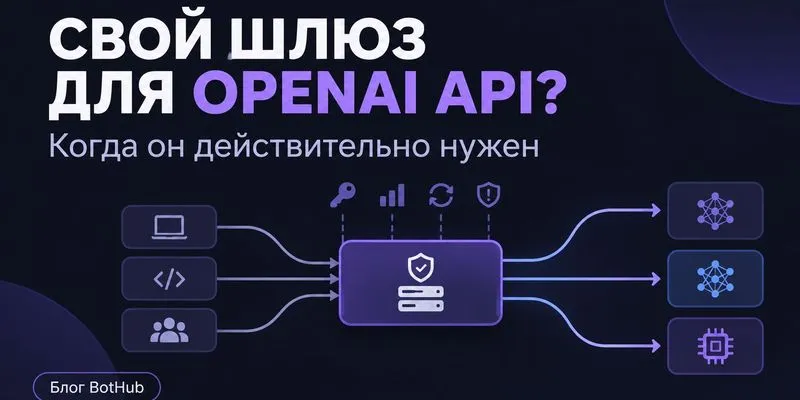
Собственный LLM-шлюз собирает в одной точке ключи, маршрутизацию, бюджеты и обработку отказов. Вместе с этим появляется ещё один сервис: его нужно развёртывать, наблюдать и восстанавливать. Перед созданием шлюза полезно назвать конкретную проблему, ради которой он попадёт в путь каждого запроса.
Когда хватит прямого вызова API
Для одного сервиса с одной AI-функцией и одним-двумя разработчиками отдельный контейнер часто добавляет больше эксплуатационной работы, чем пользы. Если провайдер поддерживает OpenAI-совместимый интерфейс, подключение через SDK обычно сводится к настройке base_url и ключа. Писать адаптер протокола в таком случае незачем.
Первый повод для дополнительного слоя — несколько приложений с разнесёнными настройками. Когда ключ хранится в четырёх местах, его ротация требует проверить каждое из них. Смена провайдера тоже затрагивает несколько сервисов. Централизация убирает эту разрозненность, хотя сама по себе ещё не требует большого самостоятельного проекта.
Второй повод — вопрос «какая функция тратит больше всего?». Для ответа иногда достаточно таблицы учёта и middleware в существующем backend. Отдельный шлюз становится полезнее, когда одинаковые правила доступа и расходов должны применяться сразу к нескольким приложениям.
Третий повод — требования к доступности. Для внутреннего помощника временный отказ модели может быть допустим. Для функции с обязательствами перед клиентом потребуется заранее определить таймауты, резервного провайдера и поведение при деградации.
Виртуальный ключ задаёт границу доступа
Приложение может получать виртуальный ключ шлюза, а настоящий ключ провайдера остаётся внутри инфраструктуры шлюза. Доступ одной функции отзывается отдельно от остальных. К виртуальному ключу можно привязать разрешённые модели, провайдеров и срок действия.
Затем возникает модель полномочий. Например, тимлид может выпускать ключи своей команды, но доступ к production требует другого права. Здесь шлюзу нужны сведения о командах, проектах, окружениях и ролях из корпоративного IAM.
Готовый продукт стоит проверять по этим требованиям до начала собственной разработки. Виртуальные ключи, лимиты, fallback и маршрутизация уже встречаются в готовых шлюзах. Специфическая иерархия доступа или бюджетов может потребовать отдельной интеграции. Её объём полезно отделить от стандартного проксирования запросов.
Ретрай после начала ответа меняет счёт
Повторная попытка при 429 или 500 выглядит естественно, пока ответ ещё не начал поступать. При стриминге клиент мог уже получить часть текста. Провайдер потратил вычисления на эту генерацию, и новый запрос способен добавить второе списание.
Политика повторов должна учитывать, успели ли прийти данные. Для шлюза приходится явно определить:
- таймаут ожидания ответа;
- условия повторного запроса и задержку между попытками;
- поведение после получения первых фрагментов;
- условия переключения на резервного провайдера;
- границы применения ключей идемпотентности.
Circuit breaker также требует различать деградацию провайдера и ошибку отдельной функции приложения. Иначе локальная проблема может повлиять на маршрутизацию запросов остальных потребителей.
Стандартные механизмы отказоустойчивости разумно искать в готовом решении. Собственная реализация получает смысл при особом сценарии: например, shadow routing отправляет запрос двум провайдерам параллельно, а один из ответов используется для сравнения качества.
Учёт начинается с потребителя запроса
Каждый вызов должен быть связан с функцией или командой, на которую относятся расходы. Без этого статистика покажет общую сумму по ключу, но не объяснит, какая возможность продукта её сформировала.
Для корреляции подходит X-Request-ID: middleware принимает входящий идентификатор либо создаёт новый и возвращает его в заголовке ответа. Дальше идентификатор сопровождает операции внутри шлюза и попадает в логи вместе с потребителем, моделью, входными и выходными токенами, стоимостью и задержкой.
Это особенно полезно, когда одно действие пользователя порождает несколько обращений к модели. Их можно связать с запросом приложения и разбирать как одну задачу.
Учёт потоковой генерации требует отдельного решения. Возможные схемы — резервирование бюджета до вызова, оценка расхода после завершения или использование usage из финального фрагмента, если провайдер его передаёт. Выбранный способ придётся согласовать с доступной статистикой провайдера и обработкой незавершённых запросов.
В Pydantic AI статистику можно получить после работы с run_stream. При этом доступность usage сама по себе не решает вопрос бюджетной политики: когда резервировать средства, как освобождать резерв и что записывать при оборванной генерации.
Закрытая вкладка требует обработки отмены
В FastAPI можно проверять await request.is_disconnected() в цикле передачи ответа. При отключении клиента шлюзу нужно обрабатывать завершение работы с upstream-запросом. Автоматическую отмену со стороны библиотеки следует проверять отдельно: Pydantic AI не обязательно отменит обращение к модели при исчезновении клиента.
Уже сгенерированные токены могут попасть в счёт. Поэтому полезно различать в учёте завершённый ответ и запрос, прерванный пользователем. Иначе рост затрат будет трудно сопоставить с количеством успешно выданных ответов.
Для асинхронного FastAPI при работе с Pydantic AI используется await agent.run(...). Синхронный run_sync предназначен для скриптов и подобных сценариев. Сам фреймворк агентов имеет смысл подключать, если нужны его типизированные зависимости, инструменты или валидация; ради одного проксируемого вызова такая зависимость может оказаться лишней.
Кэш добавляет собственные ошибки
Exact-match кэш и семантический кэш требуют разного объёма инфраструктуры. Второму нужны эмбеддинги и векторное хранилище. Кроме того, близость векторов допускает ложные попадания: вопросы о столицах Франции и Германии похожи по форме, хотя ответы у них разные.
При самостоятельной реализации семантического кэша нужны правила допуска записей. Ошибки, отказы и ответы с низкой обоснованностью стоит исключать. Ключи следует версионировать, чтобы смена эмбеддера или схемы позволяла инвалидировать старые записи.
Начальный объём шлюза можно ограничить виртуальными ключами, идентификацией потребителя, трассировкой и явной политикой таймаутов и повторов. Семантический кэш, сложную маршрутизацию и иерархические бюджеты добавляют под конкретную задачу. Для каждого такого расширения потребуется проверить отказ провайдера, частично полученный ответ и отключение клиента — именно в этих состояниях расходятся ожидания приложения и фактическая стоимость генерации.
Читайте также