 Трендовые github проекты в нашем телеграм канале. Подпишись →
Как дать агенту навигацию по архиву проектов
Когда код разбросан по десяткам рабочих папок, агенту приходится сначала выяснять, где искать нужную реализацию. В текущем репозитории помогают чтение файлов и grep. Для архива из нескольких проектов полезен отдельный поисковый индекс: запрос возвращает подходящие фрагменты и пути, после чего агент открывает конкретные файлы.
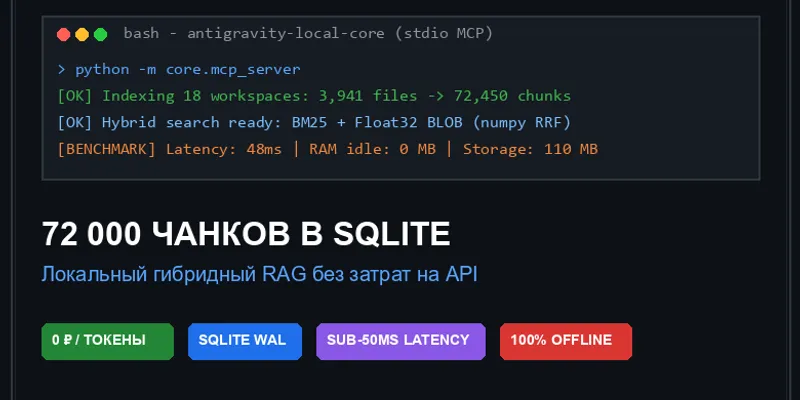
Такую схему можно собрать на Python 3.12 и SQLite, подключив поиск к IDE через MCP. В реализации antigravity-local-core индекс содержит 72 450 чанков из 18 проектов и занимает около 110 МБ. Для семантического поиска на CPU заявлено время в пределах 50 мс. Эти числа характеризуют конкретный набор документов; рассчитывать ёмкость своего сервера по ним без измерений было бы преждевременно.
Что остаётся на локальной машине
В SQLite хранятся фрагменты документов и их векторы. База работает в режиме WAL. MCP-сервер общается с клиентом через стандартные потоки ввода-вывода — stdio: отдельный HTTP-сервис и открытый сетевой порт этой схеме не нужны.
Поиск объединяет два способа отбора:
- плотные векторы, с которыми работает NumPy;
- лексическое ранжирование Okapi BM25.
Результаты сводятся через Reciprocal Rank Fusion, или RRF. Благодаря этому в выдаче участвуют оба списка кандидатов: совпадения по словам и близость векторных представлений.
Векторы записываются в SQLite как бинарные BLOB с элементами float32. При размерности 128 один вектор занимает 512 байт. Полный файл базы больше суммы векторов: в нём также находятся тексты и служебные данные. В описанном наборе итоговый размер составляет 110 МБ.
Генерация ответа при этом остаётся на стороне модели, доступной через подписку в IDE — Claude Code или Antigravity. Локальны хранение и поиск; отдельной оплаты API эмбеддингов и облачной векторной базы в этой конфигурации нет. Такая архитектура сама по себе не означает, что весь диалог с моделью выполняется офлайн.
Ограничивать проект нужно до расчёта сходства
У общего индекса быстро появляется перекос по размеру репозиториев. В одном наборе данных n8n занял около 38 тысяч чанков за счёт локализаций и тестов. По запросу про деревянный каркас его фрагменты заполняли первые восемь результатов, вытесняя небольшой профильный проект Deckor.
Если сначала взять глобальный top-8, а затем отфильтровать результаты в Python, полезных документов в этой восьмёрке уже может не оказаться. Повторная фильтрация не вернёт кандидатов, отброшенных на предыдущем шаге.
В этой реализации ограничение по project_id перенесено в SQL-запрос выборки векторов. До расчёта косинусного сходства выбираются только чанки нужного проекта. Для Deckor речь шла примерно о 2300 фрагментах; на их отбор в приведённом замере уходило около 2 мс.
Это влияет и на объём вычислений: векторный поиск получает меньший набор строк. Если агент уже знает, с каким проектом работает, идентификатор проекта полезно передавать в поисковый инструмент сразу.
Размерность эмбеддингов входит в контракт индекса
Ещё одна проблема обнаружилась при переключении провайдера. Документы были проиндексированы векторами размерности 128, а резервный FastEmbed по умолчанию выдавал запросы размерности 384. Поиск завершался ошибкой:
Embedding dimension mismatch: stored=128, query=384В реализации добавлен адаптер: длинный вектор запроса усекается до размера сохранённого, короткий дополняется нулями. Это позволяет продолжить вычисления без исключения из-за формы массива.
Однако отсутствие ошибки размерности само по себе ничего не говорит о качестве выдачи. Такой обходной путь требует отдельной проверки релевантности. При настройке резервного провайдера следует учитывать, какой моделью и с какими параметрами построен существующий индекс: одного совпадения длины массива для оценки результата недостаточно.
Поиск подстроки в путях
В Windows-проектах возникла и проблема с отбором документов по пути. Вместо шаблонного сопоставления через LIKE в реализации использовали проверку вхождения подстроки:
SELECT id, embedding
FROM rag_chunks
WHERE INSTR(LOWER(doc_id), LOWER(?)) > 0;
Здесь параметр передаётся отдельно от SQL, а INSTR ищет его внутри doc_id. Для задачи «найти путь, содержащий имя проекта» такая форма явно выражает нужную операцию и обходится без шаблона с %.
У фильтра по пути и фильтра по project_id разные назначения. Первый помогает искать документы по части имени, второй задаёт границу проекта перед ранжированием. В общем архиве эту границу стоит сохранять явно, чтобы большой соседний репозиторий снова не занял всю выдачу.
После RAG агенту всё ещё нужен файл
В простом диалоге агент может предпочесть прямое чтение файла поисковому инструменту. Для запроса о конкретной строке в CLAUDE.md это разумное поведение: путь уже известен, нужный текст доступен целиком.
Рабочую маршрутизацию можно разделить на два случая. Текущий репозиторий агент изучает через чтение файлов и grep. Для внешних проектов и архивов сначала вызывает rag_search, чтобы определить подходящие файлы и участки кода.
Дальше следует точечное чтение. Поиск может указать на builder.py и custom.py, а значения констант вроде NODE_PX=11 и AXIS_PX=9 агент берёт из самих файлов. Так сохраняется доступ к окружающему коду, импортам и условиям, которые могли остаться за границами чанка.
Для собственного архива полезно проверять именно эту цепочку: запрос, выбор проекта, найденные пути, открытие файлов. Быстрый ответ индекса имеет практическую ценность тогда, когда приводит агента к нужной реализации. Замеры задержки стоит дополнять проверкой нескольких реальных задач — особенно после смены эмбеддингов или добавления крупного репозитория.
Читайте также