 Трендовые github проекты в нашем телеграм канале. Подпишись →
Как центр сертификации с многократным запасом стал узким местом при восстановлении кластера
В service mesh с mTLS у каждого pod’а свой сертификат и свой закрытый ключ. Пока pod’ы стартуют вразнобой, выпуск сертификатов незаметен. После аварии ЦОД стартуют все сразу, и скорость восстановления кластера упирается в то, сколько подписей в секунду выдаёт центр сертификации.
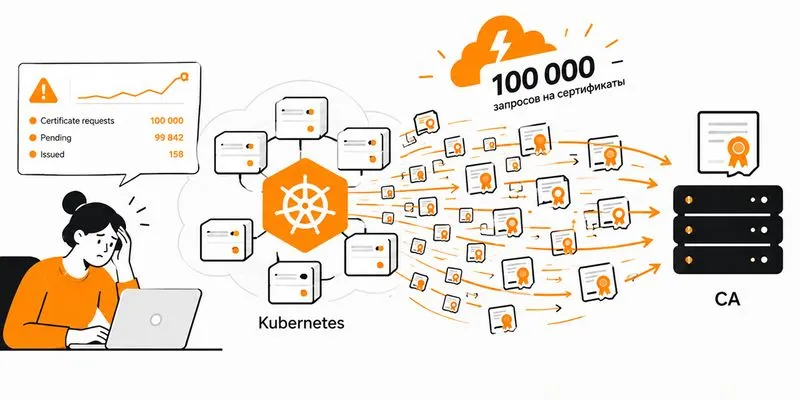
Ниже — разбор реального инцидента в крупной инфраструктуре: около 100 тысяч запросов на выпуск за несколько минут при штатной нагрузке 10–11 RPS.
Исходная схема
Kubernetes с Istio подключён к корпоративной PKI. Встроенный ЦС Istio отключён, вместо него работает промежуточный компонент: он принимает запросы на выпуск, проверяет параметры и контекст запроса по политикам безопасности и после этого передаёт запрос во внешний корпоративный центр сертификации. Правила выпуска и цепочка доверия получаются едиными для кластера и остальной инфраструктуры.
Цена такой интеграции — жёсткая зависимость: pod не начнёт обслуживать трафик, пока внешний ЦС не подпишет ему сертификат.
Арифметика штатного режима
Годовой объём — примерно 320 млн запросов на выпуск. В пересчёте на секунду это 10–11 RPS. Паспортная производительность ЦС порядка 100 RPS, реальная в этой инсталляции — 50–70 RPS. Загрузка около 15%, запас в 6–7 раз. По графикам средней нагрузки причин для беспокойства нет.
Что произошло после отключения ЦОД
ЦОД вернулся в строй, и десятки тысяч pod’ов начали запускаться одновременно. В очередь к ЦС встало около 100 тысяч запросов.
При 70 RPS такой объём обрабатывается почти 24 минуты, и это оценка для идеального случая. На практике вышло хуже:
- Запросы из хвоста очереди ждали дольше клиентского таймаута и завершались ошибкой.
- Клиенты повторяли попытку и снова вставали в очередь.
- Повторы добавляли нагрузку на ЦС, и очередь росла.
Это классический thundering herd: тысячи клиентов одновременно ломятся к ресурсу с фиксированной пропускной способностью. Kubernetes был исправен, ЦС был исправен, но кластер поднимался быстрее, чем ЦС успевал подписывать.
Сколько стоит решить проблему масштабированием ЦС
Очевидный ход — поднять производительность ЦС вертикально или горизонтально. Вот что это даёт на очереди в 100 тысяч запросов:
| Производительность ЦС | Штатная загрузка | Обработка шторма | Рост мощности |
|---|---|---|---|
| 70 RPS | ~15% | ~24 мин | — |
| 210 RPS | ~5% | ~8 мин | ~3x |
| 1050 RPS | ~1% | ~1,5 мин | ~15x |
Чтобы уложиться в полторы минуты, мощность ЦС нужно увеличить в 15 раз. Технически это выполнимо, но больше 99% времени такой ЦС будет загружен на 1%. Запас покупается под несколько минут аварии, а оплачивается круглый год.
И зависимость остаётся прежней: старт приложения всё так же ждёт, пока ЦС подпишет сертификат прямо сейчас.
Резерв заранее выпущенных сертификатов
Выпуск сертификата — медленная и равномерная операция. Потребление — резкое и пиковое. Такие процессы разделяют буфером, как это делают с кешами и очередями задач.
Схема работает так:
- Штатный режим. ЦС обслуживает обычный поток запросов, а свободный запас производительности тратит на выпуск сертификатов впрок. Готовые пары «сертификат + закрытый ключ» складываются в защищённое хранилище секретов.
- Шторм. Pod получает готовую пару из хранилища и не ждёт полного цикла выпуска. ЦС продолжает работать на своей обычной скорости и пополняет резерв.
Пиковая нагрузка переезжает с операции подписи на операцию чтения, а чтение масштабируется намного дешевле. В описываемой инсталляции хранилище отдаёт существующие секреты со standby-узлов кластера и выдерживает порядка 14 тысяч RPS. Цифра зависит от конфигурации, размера секретов и сетевых задержек, но порядок понятен: 100 тысяч чтений занимают около 7 секунд против 24 минут подписи. Время обработки аварийного пика сократилось с десятков минут до секунд.
Хранилище при этом остаётся буфером. Подпись по-прежнему ставит ЦС, меняется только момент, когда она ставится.
Требования к хранилищу
Сертификат — публичные данные. Закрытый ключ рядом с ним — критичный криптографический материал, и сотни тысяч таких ключей в обычной базе или на файловой системе создают дыру в безопасности размером с весь кластер. Поэтому хранилищу нужны:
- строгая аутентификация потребителей и разграничение прав;
- аудит каждой операции с секретом;
- отказоустойчивый кластер;
- быстрое чтение, которое масштабируется отдельно от контура выпуска;
- управление жизненным циклом объектов.
Задача про производительность PKI превращается в задачу управления секретами, и к этому надо быть готовым до старта проекта.
Что нужно решить до внедрения
Размер резерва. Маленький запас закончится раньше, чем поднимутся все сервисы. Большой означает сертификаты, которые никто не использует. Считать его нужно от сценария аварии: сколько потребителей стартует одновременно и с какой скоростью ЦС восполняет запас. При 60 свободных RPS резерв в 100 тысяч сертификатов набирается меньше чем за полчаса.
Срок действия. Сертификат стареет с момента выпуска, а в резерве он лежит без дела. Чем дольше лежит, тем меньше остаточный срок к моменту выдачи. Резерв нужно автоматически обновлять и выводить из него экземпляры, близкие к истечению.
Исчерпание запаса. Нужен заранее описанный сценарий: возврат к обычному выпуску через ЦС, постановка запросов в очередь или ограниченный режим работы. Без этого шторм просто откладывается на момент, когда резерв опустеет.
Концентрация ключей. Все закрытые ключи собраны в одном инфраструктурном слое. Его компрометация обходится дороже компрометации одной ноды, поэтому требования к модели доступа, журналированию и отказоустойчивости хранилища выше, чем к любому отдельному сервису.
Побочный эффект: секреты уезжают с файловых систем
Когда централизованное хранилище уже есть, в него начинают переносить и обычные ключи. Типичная картина с mTLS вне mesh: закрытый ключ лежит файлом рядом с приложением, и никто не может точно сказать, кто его читал, когда его меняли и что будет при компрометации сервера. В хранилище на эти вопросы отвечает журнал аудита.
Тот же принцип применим к редким и особо критичным ключам. Пример — Key Recovery Agent. При генерации ключевой пары пользователь шифрует свой закрытый ключ открытым ключом KRA, и ЦС сохраняет зашифрованную копию. Закрытый ключ KRA открывает доступ ко всему архиву пользовательских ключей, а нужен он редко. Держать его постоянно доступным в контуре ЦС незачем: ключ лежит в хранилище отдельно и выдаётся выделенной роли на время согласованной операции восстановления.
Правило отсюда простое: чем критичнее секрет и чем реже он используется, тем дальше он должен лежать от компонента, который его применяет.
Как проверить свою инфраструктуру
Два вопроса, на которые стоит ответить до аварии:
- Сколько pod’ов запросят сертификат одновременно при холодном старте всего кластера или целого ЦОД? Это число и есть реальная пиковая нагрузка на ЦС, средний RPS о ней ничего не говорит.
- Сколько минут ЦС будет разгребать такую очередь и как это соотносится с таймаутами клиентов? Если время обработки больше таймаута, повторы гарантированы.
Если ответ на второй вопрос измеряется десятками минут, выбирать приходится между ЦС с пятнадцатикратным запасом и буфером готовых сертификатов с хранилищем секретов. Первый вариант проще в эксплуатации и дороже в железе. Второй дешевле по мощности, но добавляет в инфраструктуру компонент, который теперь хранит все ключи кластера.
Читайте также