 Трендовые github проекты в нашем телеграм канале. Подпишись →
Клиент закрыл вкладку, провайдер продолжает считать токены: фоновые AI-задачи на Go и PostgreSQL
В обычном Go-сервисе r.Context() прокидывается из handler в сервис, репозиторий и все внешние вызовы. net/http отменяет этот контекст, когда клиент закрыл соединение, отменён HTTP/2-запрос или завершился ServeHTTP. Для SQL-запроса это правильное поведение: результат некому отдавать, работу можно бросить.
С LLM-вызовом на 40 секунд та же схема даёт такую последовательность:
12:00:00  POST /api/analyze
12:00:01  backend отправил запрос LLM
12:00:05  пользователь закрыл вкладку
12:00:05  r.Context() отменён
12:00:06  backend перестал ждать ответ
Backend перестал ждать. Что произошло у провайдера, из context.Canceled узнать нельзя: генерация могла остановиться, могла потратить часть токенов, могла завершиться целиком с ответом, который уже никто не прочитал. Отменено ожидание, а работа и расходы во внешней системе остались в неизвестном состоянии.
Вторая проблема — смысловая. Нажатая кнопка «Отменить анализ» и обновлённая на двадцатой секунде страница для r.Context() выглядят одинаково. Транспортный уровень начинает управлять жизненным циклом бизнес-операции, за которую уже заплачено.
Goroutine и context.WithoutCancel
Первая идея — отвязать работу от запроса:
go func() {
    ctx := context.Background()
    result, err := analyzer.Run(ctx, input)
    if err != nil {
        log.Error("analysis failed", "error", err)
        return
    }
    repository.Save(ctx, result)
}()
Вкладку теперь можно закрывать, но появляются четыре новых дыры:
- при рестарте контейнера goroutine исчезает вместе с процессом, и о задаче никто не помнит;
- состояние операции нигде не записано: клиент не узнает, что анализ ещё идёт, а повторный запуск ничем не предотвращён;
- количество goroutine ничем не ограничено — несколько сотен одновременных анализов превращаются в столько же параллельных обращений к модели;
- retry, лимиты, отмену и учёт стоимости придётся дописывать руками.
С Go 1.21 есть context.WithoutCancel: он сохраняет значения родительского контекста, но отбрасывает его отмену и deadline. Собственного механизма отмены у него нет, поэтому таймаут нужно ставить явно:
ctx, cancel := context.WithTimeout(
    context.WithoutCancel(r.Context()),
    90*time.Second,
)
defer cancel()
Это годится для коротких хвостов вроде отправки audit-события после ответа клиенту. Для LLM-задачи картина та же, что с goroutine: рестарт процесса теряет работу, retry и ограничения конкурентности нет. Заодно в фон утекают request-scoped значения, хотя воркеру достаточно явно переданных user_id, tenant_id и trace ID.
Задача как строка в таблице
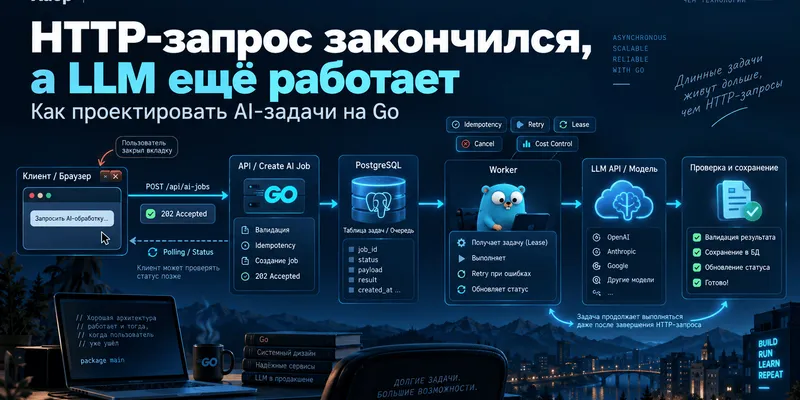
Надёжная схема начинается с того, что HTTP-запрос только создаёт задачу:
POST /api/ai/jobs
Idempotency-Key: 1b7c4e...

HTTP/1.1 202 Accepted
{ "job_id": "8c2f...", "status": "queued" }
Состояние клиент забирает через GET /api/ai/jobs/8c2f.... Код 202 означает только то, что запрос принят; гарантия появляется в момент, когда запись о задаче закоммичена в базу.
Для небольшого сервиса, где PostgreSQL уже есть, Kafka или RabbitMQ на этом этапе избыточны. Хватает одной таблицы:
CREATE TABLE ai_jobs (
    id              UUID PRIMARY KEY,
    tenant_id       UUID NOT NULL,
    idempotency_key TEXT NOT NULL,
    request_hash    BYTEA NOT NULL,
    status          TEXT NOT NULL,
    payload         JSONB NOT NULL,
    result          JSONB,
    attempts        INTEGER NOT NULL DEFAULT 0,
    run_token       UUID,
    lease_until     TIMESTAMPTZ,
    created_at      TIMESTAMPTZ NOT NULL DEFAULT now(),
    UNIQUE (tenant_id, idempotency_key)
);
attempts ограничивает число повторов, lease_until позволяет находить зависшие задачи, run_token защищает результат от записи устаревшим воркером. payload в JSONB — упрощение: для реальных документов нужно отдельно решить, где они хранятся, когда удаляются и кто имеет к ним доступ.
Идемпотентность создания
Сценарий: backend сохранил задачу, соединение оборвалось до ответа, пользователь нажал кнопку второй раз. Без защиты получится две задачи и два платных обращения к модели. Клиент поэтому передаёт Idempotency-Key, который остаётся прежним при повторной отправке той же логической операции, а backend ищет пару tenant_id + idempotency_key и возвращает уже существующую задачу с её текущим статусом.
request_hash закрывает обратный случай: ключ тот же, а тело запроса другое. На это правильно отвечать 409, иначе клиент получит результат анализа другого документа под тем же ключом.
Выбор задач воркерами
FOR UPDATE SKIP LOCKED позволяет нескольким воркерам брать разные строки и пропускать уже заблокированные без ожидания:
WITH picked AS (
    SELECT id
    FROM ai_jobs
    WHERE (
            status = 'queued'
            OR (status = 'running' AND lease_until < now())
          )
      AND attempts < 3
    ORDER BY created_at, id
    FOR UPDATE SKIP LOCKED
    LIMIT 1
)
UPDATE ai_jobs AS j
SET status      = 'running',
    attempts    = j.attempts + 1,
    run_token   = gen_random_uuid(),
    lease_until = now() + interval '3 minutes'
FROM picked
WHERE j.id = picked.id
RETURNING j.id, j.run_token, j.payload;
Блокировка строки живёт только внутри этой короткой транзакции. Транзакция PostgreSQL закрыта всё время, пока модель генерирует ответ. До полноценной очереди здесь не хватает backoff, индексов, лимитов конкурентности и обработки задач, исчерпавших попытки.
Контекст у воркера свой, и ограничивает он одну попытку выполнения:
func (w *Worker) process(workerCtx context.Context, job Job) error {
    ctx, cancel := context.WithTimeout(workerCtx, 90*time.Second)
    defer cancel()

    result, err := w.llm.Generate(ctx, job.Payload)
    if err != nil {
        return err
    }
    return w.repository.Complete(ctx, job.ID, job.RunToken, result)
}
В боевом коде результат лучше сохранять с отдельным ограниченным контекстом, чтобы истёкший таймаут попытки не помешал записать уже полученный ответ. Продление lease и graceful shutdown в примере тоже опущены.
Lease и run_token
Воркер взял задачу, поставил lease_until = 12:03:00, отправил запрос модели и через 20 секунд умер. После истечения lease задачу подберёт другой воркер.
Хуже вариант, когда первый воркер жив: он потерял связь с базой и продолжает ждать провайдера. Lease истёк, второй воркер взял ту же задачу, и теперь результат могут записать оба. Поэтому завершение выполняется условным UPDATE:
UPDATE ai_jobs
SET status = 'succeeded',
    result = $3,
    run_token = NULL,
    lease_until = NULL
WHERE id = $1
  AND run_token = $2
  AND status = 'running';
Если задача уже принадлежит другому запуску, запрос затронет ноль строк. Для операций длиннее lease его нужно периодически продлевать, тоже с проверкой run_token.
Граница exactly once
Воркер получил ответ модели и упал до записи в PostgreSQL. Lease истёк, второй воркер повторил вызов. В базе одна задача, у провайдера два выполненных и, вероятно, два оплаченных запроса. Локальная транзакция не может атомарно зафиксировать внешний вызов, поэтому схема даёт at-least-once с защитой от повторного принятия результата. Идемпотентность на стороне провайдера помогает, если она есть именно у нужного endpoint — это проверяется отдельно для каждого API.
Отсюда два разных учёта денег. Стоимость у провайдера считается по попыткам:
AI Job
 ├── Attempt 1   provider_cost   failed / unknown
 └── Attempt 2   provider_cost   succeeded
Списание с пользователя привязывается к логической операции: лимит резервируется при создании задачи, списывается после принятия результата и освобождается при неуспехе. Историю попыток стоит хранить отдельно, иначе позже будет нечем объяснить рост счёта за LLM API при прежнем числе завершённых задач. Для таймаута после отправки запроса честный статус попытки — unknown: сколько токенов провайдер успел потратить, воркер не знает.
Retry по типу ошибки
Правило «ошибка → повтор» здесь стоит денег. Payload, который не проходит обязательную валидацию, после трёх попыток останется невалидным. Временная недоступность провайдера — нормальный повод повторить. Таймаут после отправки запроса относится к третьей категории: операция могла завершиться на той стороне, и решение о повторе зависит от стадии выполнения, наличия дедупликации у провайдера и цены повторного запуска. Для дорогих задач автоматический retry разумно вынести в отдельную политику или отключить.
Streaming и отмена
Потоковая выдача ответа с этой моделью совместима: воркер пишет результат в хранилище и параллельно публикует события, frontend подписывается на них через SSE. Обрыв соединения завершает подписку, задача продолжает выполняться. SSE сам поток не хранит, поэтому для восстановления промежуточных событий после реконнекта их придётся где-то сохранять. Для первой версии достаточно итогового результата и polling.
Пользовательская отмена — отдельный endpoint POST /api/ai/jobs/{id}/cancel. Искать CancelFunc в памяти конкретного инстанса бессмысленно: запрос может прийти на другую реплику. Намерение фиксируется в строке задачи (cancel_requested = true), воркер периодически его проверяет и отменяет исходящий запрос. Остановит ли провайдер генерацию и выставит ли счёт, остаётся неизвестным, поэтому «задача отменена пользователем» и «внешнее выполнение отменено» в продукте фиксируются как два разных события.
Метрики
Latency endpoint создания задачи может быть 30 мс, пока пользователь ждёт результат минуту. Нужны время ожидания в очереди, длительность выполнения, число попыток и доля задач без повторного запуска, а также счётчики:
jobs_created
jobs_accepted
job_retry_rate
lease_expired_count
provider_attempts
provider_unknown_outcomes
cost_per_accepted_job
cost_per_accepted_job полезнее цены токена: если вызов подешевел, а job_retry_rate вырос, стоимость готового результата может остаться прежней. Сравнивать провайдеров стоит по этой метрике.
Когда durable job избыточен
Короткий ответ за пару секунд, который не нужно сохранять, спокойно живёт в синхронном handler с r.Context(): клиент ушёл — операция отменена. Выносить вызов в ai_jobs стоит, когда совпадают несколько признаков: операция длится десятки секунд, стоит ощутимых денег, её результат сохраняется, пользователь может вернуться за ним позже, а повторный запуск создаёт дубли или лишние списания.
Читайте также