 Трендовые github проекты в нашем телеграм канале. Подпишись →
Гипотеза под алертом через четыре минуты: HolmesGPT в шести кластерах
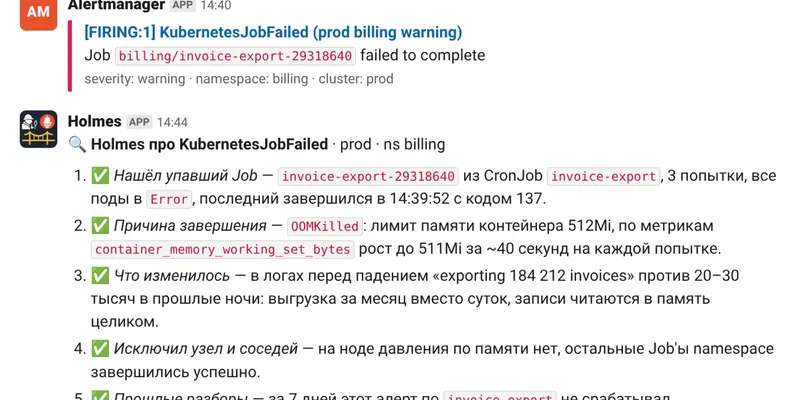
Алерт TCPListenQueueOverflow приходит в чат с зашитым советом поднять net.core.somaxconn. Через 4 минуты 17 секунд под ним появляется разбор: переполнение есть на одном хосте, за предыдущие семь дней его не было, счётчик SYN cookies почти не вырос, а соединения перестал принимать sshd — он упёрся в MaxStartups из-за 180 попыток входа с двух адресов за 15 минут. Совет из аннотации увёл бы дежурного в сторону. Разбор стоил пять центов.
Так работает HolmesGPT — SRE-агент под лицензией Apache 2.0, с октября 2025 года в CNCF Sandbox. Ниже цифры и настройки по итогам месяца эксплуатации версий 0.41–0.42 в шести Kubernetes-кластерах трёх проектов.
Что внутри агента
Модель получает вопрос, выбирает инструмент, читает результат и вызывает следующий. На один алерт уходит два-три десятка вызовов, в запутанных случаях — под сотню.
- Toolsets — наборы инструментов: Kubernetes (ресурсы, логи Pod’ов), Prometheus, VictoriaLogs, ArgoCD, Grafana, проверки сетевой доступности. Свой набор описывается YAML-файлом со скриптами или подключается как MCP-сервер.
- Skills — файлы
SKILL.mdс именем и описанием. Агент видит описания, текст подгружает по необходимости. - Модель — любая, доступная через litellm: Anthropic, OpenAI, Bedrock, Gemini, Ollama, OpenRouter, любой OpenAI-совместимый API.
Ставится отдельной инсталляцией на каждый кластер: агент работает под ServiceAccount с правами на чтение и чужих кластеров не видит. Памяти занимает около полугигабайта.
additionalEnvVars:
  - name: MODEL
    value: fast
  - name: OVERRIDE_MAX_CONTENT_SIZE
    value: "400000"
modelList:
  fast:
    model: openrouter/deepseek/deepseek-v4.1-flash
    api_key: "{{ env.OPENROUTER_API_KEY }}"
    temperature: 0.5
    extra_body:
      provider:
        zdr: true
toolsets:
  kubernetes/core: { enabled: true }
  kubernetes/logs: { enabled: true }
  prometheus/metrics: { enabled: true }
  victorialogs: { enabled: true }
  skills: { enabled: true }
  bash: { enabled: false }
  internet: { enabled: false }
  robusta: { enabled: false }
enableTelemetry: false
Наборы bash и internet в чарте включены по умолчанию, их выключают явно. Запрет на изменения обеспечивает RBAC; фраза в промпте барьером не является.
Мост к Alertmanager
В открытой версии HolmesGPT умеет только забирать алерты: holmes investigate alertmanager разово читает активные и разбирает их. Приёмника вебхуков в HTTP-сервере нет. Этот пробел закрывает holmes-alert-bridge — сервис на Go под Apache 2.0. Почти вся его логика защищает бюджет:
- сразу отвечает 200, расследование идёт в фоне;
- allowlist по имени алерта, с пустым списком сервис откажется стартовать;
- дедупликация по эпизоду: имя алерта, namespace и время начала (для CronJob ключом служит имя CronJob’а);
- троттлинг: по умолчанию два расследования в час и десять в сутки;
- один воркер, расследования идут по очереди;
- через 15 минут bridge рвёт стрим, и Holmes останавливается на границе текущего шага;
- отметки дедупликации и троттлинга хранятся в SQLite, PostgreSQL или MySQL и переживают рестарт.
За месяц в одном кластере Alertmanager доставил в bridge 645 алертов, до агента дошёл 41.
receivers:
  - name: holmes
    webhook_configs:
      - url: http://holmes-alert-bridge.holmes.svc:8080/webhook
        send_resolved: false
route:
  routes:
    - receiver: holmes
      matchers:
        - severity =~ "warning|critical"
      continue: true
Если в дереве маршрутов нет явного catch-all, continue: true может отнять доставку у алертов, которые раньше падали в корневой получатель. Тогда bridge добавляют вторым webhook_configs к существующим получателям, а отбор оставляют на allowlist.
Ещё один бесплатный фильтр — group_wait. При трёх минутах ожидания перед первой отправкой до агента из десятков эпизодов доезжают единицы: всё, что живёт минуту-две, гаснет раньше.
Сколько стоит разбор
Разбор алерта — около миллиона токенов, из которых модель генерирует пару десятков тысяч. Остальное составляет история, которую агент пересылает на каждом ходу. Первый прогон на glm-5.2 съел больше миллиона входных токенов и обошёлся в десятки рублей.
Отбор из восьми моделей на 52 прогонах показал две вещи. Разброс цены внутри одной модели оказался больше разницы между моделями, так что сравнивать по одному прогону бессмысленно. И половина кандидатов провалила задачу с известным ответом одинаково: уверенно сообщила, что управляемого автоскейлера в кластере нет, потому что среди Pod’ов его не видно. Обе модели дешевле deepseek-v4-flash эту задачу не решили.
Для агента важнее прайса за миллион токенов три свойства модели:
- Дешёвое чтение кэша. По оценке обратным счётом, из кэша читается около 90 % входных токенов.
- Окно контекста. При 200 тысячах Holmes начинал сжимать историю около 126 тысяч, потом заново запрашивал собранное. С окном в 400 тысяч сжатия прекратились.
- Надёжный вызов инструментов. Если модель отдаёт аргументы строкой с JSON внутри, Holmes падает на валидации и разбор теряется целиком.
Итог за 30 дней: на DeepSeek V4.1 Flash разбор идёт 2–3 минуты и стоит около 10 центов, на Claude Sonnet 5 — около минуты и 25–30 центов. Месячный счёт — четыре-пять долларов на проект.
Троттлинг bridge защищает только путь от Alertmanager. Ручные запросы к /api/chat и другие клиенты идут мимо него, поэтому на ключ провайдера ставят месячный лимит.
Что уходит провайдеру модели
Всё, что прочитал агент: строки логов, манифесты, события, метки метрик. Секрет от обычной строки он не отличает. До первого алерта нужно сделать четыре вещи.
- Проверить логи приложений на токены, пароли и персональные данные и починить это в самих приложениях.
- Включить Zero Data Retention в двух местах: настройкой аккаунта OpenRouter и параметром
provider.zdr: true. Проверка — живой запрос: обращение к провайдеру вне ZDR-списка возвращает ошибкуZDR violation. - Закрыть API Holmes. По умолчанию
/api/chatдоступен без аутентификации любому Pod’у кластера. Варианты: NetworkPolicy или ключHOLMES_API_KEY. - Считать правило в skill’е вида «не цитируй персональные идентификаторы» пожеланием. Агент в целом слушается, но технического ограничения тут нет.
Skills: паспорт кластера и подсказки в правилах
Самый полезный текст во всей настройке — skill с описанием кластера, который агент читает первым. В нём перечислены namespace’ы и их назначение, внешние базы, до которых нельзя дотянуться через kubectl, владение инфраструктурой со стороны ArgoCD (значит, kubectl edit советовать нельзя) и список нормальных для кластера событий: ночная замена узлов с 02:00 до 03:00 UTC, три ретрая у отчётных Job’ов.
Короткую инструкцию можно положить прямо в правило алерта — аннотации попадают в вопрос агенту целиком:
- alert: KubernetesJobFailed
  annotations:
    summary: "Job {{ $labels.job_name }} failed"
    ai: >-
      Jobs in the `jobs` namespace are retried by the scheduler.
      Check whether the next run succeeded before calling it an incident.
Наблюдения из практики:
- Инструмент, не названный в skill’е, почти не вызывается. ArgoCD, Grafana и TCP-проверки были подключены, и агент ими практически не пользовался, пока их не вписали в шаги.
- Запрет передавать
end: "now"стоял в инструкциях toolset’а логов, модель его игнорировала — десятки упавших вызовов. Помогло то же правило в паспорте кластера. - Встроенные toolset’ы в статусе failed всё равно попадают в системный промпт. Их выключают явно.
- Имена полей логов зависят от коллектора: у vector это
kubernetes.pod_namespace, у fluent-bit —kubernetes.namespace_name. Схему нужно описать агенту.
Skill, который месяц возвращал ноль
Перед расследованием агент ищет в логах bridge прошлые разборы того же алерта. В двух контурах из трёх запрос искал имя алерта голой фразой, а в LogsQL голая фраза ищется только в _msg, где лежит ровно investigation done:
{app="holmes-alert-bridge"} "investigation done" "KubernetesJobFailed"             → 0 записей
{app="holmes-alert-bridge"} "investigation done" alertname:="KubernetesJobFailed"  → 73 записи
Агент выполнил сотни таких запросов и каждый раз писал «прошлых разборов нет», включая эпизод, разобранный за месяц девятнадцать раз. Ошибок не возникало: пустой ответ валиден. Каждый запрос из skill’а нужно хотя бы раз выполнить руками и убедиться, что он что-то возвращает.
Грабли эксплуатации
- Висящий алерт разбирается раз в сутки. Окно дедупликации по умолчанию 24 часа. В одном контуре на повторы уходила почти половина бюджета. Параметр
dedupWindowувеличивают до нескольких суток. - Цены в
modelListломают окно контекста. Holmes 0.41 после этого падает на первом вызове инструмента, спасаетOVERRIDE_MAX_CONTENT_SIZE. В 0.42 падения нет, но окно по умолчанию 200 тысяч. kubectlпадает по памяти на больших списках. Лимит на один вызов инструмента задаётся отдельно:TOOL_MEMORY_LIMIT_MB.- Парные правила дают два разбора. Общее правило и его специализированный двойник в allowlist означают два расследования одного инцидента с разницей в секунды.
- Аномально дешёвый разбор. Дважды агент прочитал пару skills, не сделал ни одного запроса к данным и написал, что у него нет доступа к метрикам. Формально разбор успешен и стоит доли цента.
- На сам bridge нужны алерты, и в его allowlist их не добавляют:
- alert: HolmesBridgeInvestigationsFailing
  expr: increase(holmes_bridge_investigations_total{status!="ok"}[1h]) > 0
- alert: HolmesBridgeThrottling
  expr: increase(holmes_bridge_alerts_throttled_total[1h]) > 0
Точность гипотез в 90–95 % пока остаётся оценкой по ощущениям дежурных: размеченной выборки разборов против реальных причин инцидентов нет. Поэтому агент работает с правами только на чтение, а его ответ в чате помечен как гипотеза.
Читайте также