 Трендовые github проекты в нашем телеграм канале. Подпишись →
Агент пишет быстрее, чем команда успевает проверять
Типичная картина осени 2026 года: разработчик с агентом за вечер собирает фичу, на которую раньше ушла бы неделя, и открывает MR на полторы тысячи строк. MR лежит три дня, потому что у ревьюера в очереди ещё четыре таких же. Потом приходит approve с одним комментарием про имя переменной, задача уезжает в QA и застревает там. Через неделю в проде всплывает то, что в этих полутора тысячах строк никто толком не прочитал.
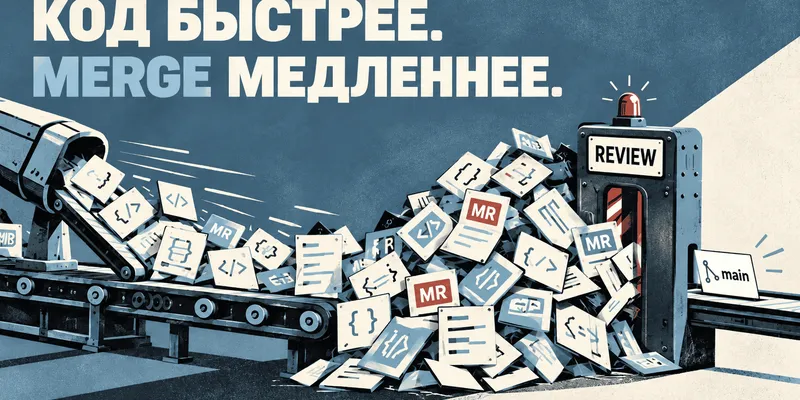
Генерация изменений подешевела, а проверка, интеграция и выкладка работают с прежней пропускной способностью. Когда изменения поступают быстрее, чем система их обрабатывает, растут очередь, объём незавершённой работы и время поставки. Где скопится очередь, зависит от команды: у одной это ревью, у другой QA, у третьей интеграция.
Что говорят цифры
Faros AI, «The AI Productivity Paradox» (июль 2025). Телеметрия по 10 с лишним тысячам разработчиков из 1 255 команд. Те, кто активно пользуется AI-ассистентами, закрывали на 21% больше задач и вливали на 98% больше PR. Одновременно время ревью выросло на 91%, средний размер PR — на 154%, число багов на разработчика — на 9%. Связи с результатами на уровне компании исследователи не нашли.
Faros AI, «The Speed Trap» (18 сентября 2026). 12 месяцев телеметрии, 22 тысячи разработчиков из 4 тысяч команд. Время в QA выросло на 300,6% — сильнейшее ухудшение среди метрик потока. PR всё ещё на 71,8% крупнее базового уровня, инцидентов в месяц стало больше на 125,4%. Рост числа PR, влитых без ревью, полгода назад был 31,3%, сейчас — 76,3%.
CircleCI, State of Software Delivery 2026. 28,7 млн прогонов CI за сентябрь 2025 года. Ежедневных прогонов стало на 59% больше год к году. У медианной команды активность в feature-ветках выросла на 15%, в main — упала на 7%. Доля успешных сборок main опустилась до 70,8%, это минимум за пять лет; медианное время возврата к зелёной сборке — 72 минуты. Нарастить и разработку, и прохождение изменений через main одновременно смогли меньше 5% команд.
DORA. В отчёте 2024 года рост использования AI на 25% сопровождался оценочным падением скорости поставки на 1,5% и стабильности на 7,2%. В 2025 году связь со скоростью поставки стала положительной, со стабильностью осталась отрицательной. Без сильной автоматизации тестов и быстрой обратной связи рост объёма изменений превращается в нестабильность.
Источники расходятся в деталях. Faros и CircleCI продают инструменты аналитики и ускорения поставки, DORA опирается на опросы, а всё перечисленное — корреляции. Направление у всех одно, поэтому его можно считать надёжным, а точные проценты — ориентиром.
Где ломается ревью
Размер MR
Агент сам по себе не оптимизирует размер диффа. Попросили фичу — получили фичу целиком, с рефакторингом соседнего модуля «заодно». Классический пример: задача «добавить поле в ответ сервиса», а в MR ещё переписанный маппинг, пара обновлённых зависимостей и причёсанные тесты. По задаче из нескольких сотен строк — строк двадцать, и два дня ревью уходят на выяснение, зачем трогали остальное.
Старое исследование SmartBear на командах Cisco даёт ориентир: 200–400 строк за одно ревью, скорость до 500 строк в час, сессии около часа. В таких рамках ревью находило 70–90% дефектов.
Границу изменения стоит задавать до того, как агент начал писать: один MR — одна логически связная задача, которую можно независимо понять, проверить и откатить. Число строк при этом остаётся индикатором стоимости ревью. MR на 600 строк из DTO, маппера и юнит-тестов проверить проще, чем 120 строк, которые трогают авторизацию платежа, границы транзакций или миграцию базы. Число затронутых модулей, изменения публичных контрактов и радиус поражения весят столько же, сколько объём диффа.
Очередь вместо «медленного ревьюера»
Когда MR висят по три дня, хочется списать это на ревьюеров. Чаще входящий поток просто больше пропускной способности. В инженерных практиках Google есть ограничение: первый ответ на запрос ревью — максимум за рабочий день. Речь о первом ответе, полное ревью может идти дольше.
Агенты добавляют свой эффект: пока MR ждёт, автор открывает следующий, потом ещё один. По данным Faros 2025 года, разработчики с высоким использованием AI касаются на 47% большего числа PR в день.
Рабочая эвристика — не больше двух своих открытых MR на человека. Первую неделю такое правило раздражает, потом авторы сами идут к ревьюерам с вопросом, чем помочь. В итоге управлять нужно глубиной общей очереди: шесть авторов по два MR дают очередь хуже, чем три по одному.
Штамп или допрос
Под давлением объёма ревью скатывается в одну из крайностей. Штамп: approve без чтения, «тесты же зелёные». Допрос: ревьюер требует объяснить каждую сгенерированную строку, и MR неделю ходит по кругу. Первая крайность пропускает ошибки, потому что человеческой проверки фактически не было. Вторая — потому что внимание уходит на стиль.
Отдельная ловушка — рефакторинг «без изменения поведения». Клиент внешнего API переносят на другую HTTP-библиотеку, тестов много, сборка зелёная. Тесты при этом проверяют разбор ответа, его проще всего замокать. Меняется как раз то, что уходит во внешнюю систему и что происходит при её отказе. Порядок для такого рефакторинга: сначала тестами зафиксировать внешние эффекты и поведение при отказах, потом менять реализацию.
Ревью по уровню риска
AI-ревью уже помогает: в свежем отчёте Faros у команд, которые им пользуются, первое ревью приходит быстрее, а доля неудачных изменений ниже (опять корреляция). Доверие при этом невысокое: по DORA 2025 высоко доверяют результатам AI 24% опрошенных, 30% доверяют мало или не доверяют. Если агент написал и проверил код, а человек нажал кнопку, независимой проверки не было.
Пример политики:
| Изменение | Ревью человеком |
|---|---|
| Механические правки, полностью покрытые детерминированными проверками | не нужно, хватает CI |
| Обновление зависимостей | по риску; мажорная версия — да |
| Простой DTO или маппер | один ревьюер |
| Бизнес-логика | обязательно |
| Авторизация, платежи, безопасность | усиленное; для самого критичного — второй независимый ревьюер |
| Миграция БД | отдельный путь проверки |
Линтеры, тесты, статанализ и AI-ревью отрабатывают первыми в CI. Человек получает MR без мусора и тратит внимание пропорционально риску.
Метрики, которые показывают узкое место
Число PR и закрытых задач с агентами растёт само по себе и про поставку ничего не говорит. Локализовать затор помогают:
- время до первого ответа на MR;
- длительность ревью и число кругов;
- время от открытия MR до merge;
- время от merge до production, включая QA;
- глубина очереди ревью и доля MR, влитых без ревью;
- change failure rate — изменения, приведшие к откату, хотфиксу или сбою в production (упавшие сборки CI сюда не входят).
Предупреждение о крупном MR в GitLab CI
Простейшее правило укладывается в одно задание:
mr-change-size-warning:
  stage: .pre
  rules:
    - if: '$CI_PIPELINE_SOURCE == "merge_request_event"'
  allow_failure: true   # предупреждение, merge не блокируется
  variables:
    GIT_DEPTH: "0"      # базового коммита MR может не быть в неполном клоне
  script:
    - |
      stats="$(git diff --numstat "$CI_MERGE_REQUEST_DIFF_BASE_SHA...$CI_COMMIT_SHA" \
        -- . ':(exclude)*.lock' ':(exclude)**/generated/**' |
        awk '$1 ~ /^[0-9]+$/ && $2 ~ /^[0-9]+$/ { a += $1; d += $2 } END { print a+0, d+0 }')"
      added="${stats% *}"; deleted="${stats#* }"; changed=$((added + deleted))
      echo "Изменено строк: $changed (+$added / -$deleted)"
      if [ "$changed" -gt 400 ]; then
        echo "MR крупнее 400 строк: разбейте на части, которые можно проверить по отдельности"
        exit 1
      fi
Детали задания:
- задание падает при превышении порога, а
allow_failure: trueпревращает падение в жёлтое предупреждение; - считаются добавленные плюс удалённые строки, бинарные файлы отсекает проверка на числа в
awk; - lock-файлы и сгенерированный код исключены, список исключений у каждого репозитория свой;
- дифф берётся от
CI_MERGE_REQUEST_DIFF_BASE_SHA, поэтому ушедшая вперёд целевая ветка не раздувает результат; GIT_DEPTH: "0"тянет всю историю. В монорепозитории полный клон ради подсчёта строк сам нагружает CI, там статистику диффа лучше брать через API GitLab.
Порог 400 строк — сигнал о стоимости ревью. Миграция, массовое переименование или обновление зависимостей бывают огромными и при этом простыми для проверки.
Пять вопросов на ретро
- Какой средний размер MR сейчас и каким он был полгода назад?
- Сколько MR ждёт первого ответа и сколько кругов проходит ревью?
- Где дольше всего лежит задача после merge: в QA, на интеграции, на выкладке?
- Что в проверке делает автоматика, что человек, и соответствует ли глубина ревью риску?
- Какая доля MR вливается без ревью, и знает ли об этом команда?
Начинать стоит со второго и третьего: они считаются за вечер по истории репозитория и трекера. В маленькой команде, где ревью идёт голосом за соседним столом, очереди может не быть вовсе; сильнее всего эффект бьёт по командам, где проверяющих меньше, чем пишущих. Прежде чем подключать ещё одного агента, измерьте, куда уже переехала очередь.
Читайте также